Corrigé sujet 1 / Épreuve pratique NSI 2026 : codage RLE, listes et boucles while en Python
Le sujet 1 de l'épreuve pratique NSI 2026 compresse une image en niveaux de gris par codage RLE. Écriture de la fonction de décodage, test sur deux images, puis correction du cas des zones de plus de 255 pixels identiques.
Le sujet 1 de l'épreuve pratique NSI 2026, aussi appelée ECE de NSI, part d'une idée simple : une image en niveaux de gris qui contient de grands aplats se décrit plus efficacement par des couples (compte, valeur) que pixel par pixel. C'est le codage RLE, et en une heure tu dois écrire son décodage, le tester sur de vraies images, puis réparer ce qui casse quand une zone dépasse 255 pixels. C'est l'un des trois sujets zéro publiés pour la session 2026, donc l'un des plus travaillés en classe. Quatre questions, dont trois avec appel du professeur : le temps de rédiger ce que tu vas lui dire fait partie de l'épreuve.
rle.py, bac_nsi_32.png et bac_nsi_256.png dans le même dossier
Installer pillow : pip install pillow
Ouvrir rle.py dans ton éditeur Python
Question 1 / Longueur du codage RLE
On te demande de trancher si la liste produite par le codage RLE est forcément plus courte, ou aussi longue, que la liste de départ...
Le truc, c'est qu'il ne faut pas se laisser embobiner par le mot « codage »... Tu lis « codage RLE », tu penses "ça raccourcit", tu réponds oui. Or personne ne te demande ce que la méthode promet, on te demande ce que le code fait. Et ce que le code fait est écrit noir sur blanc dans l'énoncé :
La liste de couples est elle-même aplatie, c'est-à-dire représentée par une liste de longueur paire [compte1, valeur1, compte2, valeur2, ...].
Deux cases par run. Toujours deux. Quelle que soit la longueur du run. Alors qu'est-ce qui pourrait bien se passer quand un run ne contient qu'un seul pixel ?
On peut dresser le tableau, il tient en trois lignes :
Longueur du run
Cases consommées dans la liste RLE
Bilan
1
2
on perd une case
2
2
match nul
3 et plus
2
on gagne au moins une case
La réponse est donc non. Mais maintenant que tu l'as compris, le plus propre pour répondre est de donner un contre-exemple. Et le meilleur contre-exemple est le plus simple : la liste [0, 1] ne contient aucune répétition, donc si on l'encode, elle donne [1, 0, 1, 1], deux fois plus longue. Dans le pire des cas, une liste sans aucune répétition double de taille.
Donc tu appelles le prof, réponse : "non, pas forcément" et tu lui montres ce contre-exemple.
Les pièges classiques
Répondre « oui » parce que le vocabulaire y invite, sans regarder ce que le codage fait réellement.
Donner la réponse sans contre-exemple. « Déterminer » veut dire justifier : une affirmation seule ne vaut rien devant l'examinateur (de toute façon, il te le demandera).
Enchaîner sur la question 2 sans avoir fait l'appel professeur. C'est signalé dans l'énoncé, c'est prévu au barème.
Chercher un contre-exemple sophistiqué alors que deux valeurs différentes suffisent. Le jour J, le plus court est le meilleur.
Question 2 / Écrire le décodage
Le sujet fournit codage_rle et te demande d'écrire le corps de decodage_rle, la fonction qui refait le chemin en sens inverse. Les tests de test_codage sont fournis, et l'énoncé précise qu'on peut les compléter.
Bonne nouvelle : le retour est plus facile que l'aller. codage_rle avance dans la liste à un rythme irrégulier, occ cases d'un coup, et c'est pour ça qu'elle est écrite avec deux boucles imbriquées. Le décodage, lui, avance à un rythme parfaitement régulier : deux cases, deux cases, deux cases, jusqu'au bout. Un compte, une valeur, et on recommence.
Je t'encourage à te dérouler le tableau au brouillon avant de coder, sur l'exemple que le sujet te donne déjà dans test_codage :
i
liste_rle[i] (le compte)
liste_rle[i + 1] (la valeur)
Ce qu'on ajoute
0
2
255
2 fois 255 : 255, 255
2
1
0
1 fois 0 : 0
4
3
255
3 fois 255 : 255, 255, 255
Trois lignes, et on comprend direct le fonctionnement.
Python
defdecodage_rle(liste_rle):
"""Renvoie la liste d'octets obtenue à partir de la liste liste_rle obtenue
par compression RLE"""
liste_octets = []
i = 0while i < len(liste_rle):
cpt = liste_rle[i] # le compte
valeur = liste_rle[i + 1] # la valeurfor k inrange(cpt): # on répète 'cpt' fois...
liste_octets.append(valeur) # ... ajouter 'valeur' en fin de liste
i = i + 2# '+2' car on traite les valeurs de 2 en 2return liste_octets
Deux points méritent ton attention. D'abord i = i + 2 : c'est la ligne qui fait toute la différence, et c'est aussi celle qu'on oublie de changer quand on part d'un parcours de liste classique. Ensuite, la boucle for k in range(cpt) ne se sert jamais de k, elle sert uniquement à répéter cpt fois la même opération. Enfin, on n'a pas besoin de vérifier que i + 1 existe : l'énoncé garantit que la liste RLE est de longueur paire.
Une autre forme beaucoup plus compacte consiste à faire avancer range de deux en deux et à répéter la valeur par multiplication de liste :
Python
defdecodage_rle(liste_rle):
liste_octets = []
for i inrange(0, len(liste_rle), 2):
liste_octets = liste_octets + [liste_rle[i + 1]] * liste_rle[i]
return liste_octets
Bien sûr, ce n'est pas la seule façon, mais souviens-toi : mieux vaut 'fait' que 'parfait'. En une heure, la version du dessus est celle que tu écris sans te tromper.
Et comme toujours... on teste son code ! L'énoncé invite à compléter test_codage, donc on le complète. Le cas de la liste vide, un run seul, et surtout un aller-retour complet : on code puis on décode, et on doit retomber sur la liste de départ.
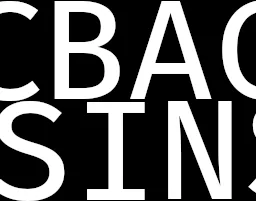
Aucune erreur, aucun message, deux fichiers produits. Et c'est précisément le piège : si tu t'arrêtes à la console, tu conclus que tout va bien. Ouvre les deux fichiers .dec.png. Le premier est identique à l'original. Le second est une image de 256 pixels de large sur 201 de haut au lieu de 256 sur 256, avec le dessin décalé vers la gauche, comme si on avait découpé une bande dans la hauteur.
Le fichier `bac_nsi_256.png` après encodage/décodage
Les pièges classiques
Conclure que "ça marche" parce que rien n'a planté. Une absence d'erreur n'est pas un résultat, et cette question est construite exactement là-dessus.
Ne pas ouvrir les images produites. Le sujet dit « observer la différence de comportement » : la différence est visuelle avant d'être numérique.
Tester une seule des deux images. C'est la comparaison qui porte l'information, pas chaque image prise à part.
Question 4 / Les runs trop longs
L'énoncé pose lui-même le diagnostic, puis te demande une démarche, et enfin son implémentation.
Le problème précédent est lié au fait que sur des grandes images, il est possible d'avoir plus de 255 pixels de la même couleur.
Voilà la raison du décalage, mais il est important de bien comprendre : la fonction enregistrer_octets annonce que toute valeur supérieure à 255 est ramenée à 255. Cela signifie que s'il y a plus de 255 pixels de la même couleur, disons 260 pixels noirs, on devrait enregistrer [260, 0]... mais au lieu de cela, enregistrer_octets va enregistrer [255, 0]. Après décodage, on aura donc 255 pixels noirs au lieu des 260 d'origine... Ce qui va donc créer un décalage dans les pixels après décodage : l'image décodée n'est pas identique à l'image qui avait été encodée.
Ainsi, le compteur de pixels de même valeur doit tenir dans un octet, donc il ne peut pas dépasser 255.
Comment faire ?
Au début on peut se dire que si le nombre occ (dans codage_rle) dépasse 255, il suffit de couper en deux, en stockant :
déjà 255 fois le pixel,
puis occ - 255 fois le même pixel.
Cela fonctionne... mais uniquement si occ est inférieur ou égal à 510... sinon, on n'a fait que déplacer le problème.
On décide donc qu'un run ne dépassera jamais 255 pixels. Il va falloir intégrer cette condition dans la boucle while déjà présente dans le code de la fonction codage_rle, et rien d'autre à changer dans la boucle.
Python
defcodage_rle(liste_octets):
"""Renvoie une liste d'octets obtenue par compression RLE"""
liste_rle = []
i = 0while i < len(liste_octets):
valeur = liste_octets[i]
occ = 1while i + occ < len(liste_octets) and liste_octets[i + occ] == valeur and occ < 255:
occ += 1
liste_rle.append(occ)
liste_rle.append(valeur)
i += occ
return liste_rle
La ligne modifiée est la condition du while intérieur, et c'est la seule. Comme la ligne i += occ utilise la valeur de occ réellement écrite, le run suivant reprend pile là où le précédent s'est arrêté : les pixels restants forment un nouveau run, de la même valeur, et sont codés dans le couple d'après.
Reste la question du décodage, et c'est le point que je te conseille de préparer avant d'appeler le professeur : l'énoncé annonce une modification des deux fonctions, mais avec notre démarche, il n'y a rien à changer dans decodage_rle. Par exemple, la suite [255, 0, 5, 0] se décode en 255 zéros puis 5 zéros, soit les 260 zéros attendus, sans que la fonction ait besoin de savoir qu'ils viennent de deux couples. C'est ce que tu dois dire à ton examinateur.
Et comme toujours... on teste son code !
D'abord sur une liste construite à la main, 260 valeurs identiques, dont je connais le codage attendu avant de lancer quoi que ce soit : 255 puis 5.
Ensuite sur les deux images fournies avec le sujet, la grande comme la petite. En effet, maintenant que tu as modifié la fonction codage_rle, il faut vérifier que ce qui fonctionnait déjà (donc le codage-décodage de la petite image) fonctionne toujours ! Parce qu'une correction qui répare l'une en cassant l'autre n'est pas une correction.
De même, il faut repasser les tests du début avec test_codage : les tests de la question 2 doivent toujours passer.
Se lancer dans un découpage en deux (255 puis occ - 255) sans avoir compris que cela déplaçait le problème sans le résoudre
Écrire occ = min(occ, 255) après la boucle interne sans corriger l'avancée de i. Les pixels en trop sont alors sautés : aucune erreur, une image fausse.
Modifier decodage_rle "parce que l'énoncé le dit", au risque de casser ce qui marchait. La bonne réponse est d'expliquer pourquoi ce n'est pas nécessaire.
Ne tester que sur la grande image. Il faut revérifier la petite, qui fonctionnait avant la modification.
Oublier de relancer test_codage après avoir touché à codage_rle.
Récapitulatif des notions
Parcours d'une liste avec une boucle while et un pas de 2
Boucle for de répétition dont la variable ne sert pas
Boucles imbriquées et condition d'arrêt composée
Assertions et fonction de test, complétées à partir des exemples de l'énoncé
Codage, décodage et compression sans perte
Limite de l'octet : les valeurs vont de 0 à 255, compteurs compris
 Épreuve pratique 2026 / Sujet 3